کاربرد پایتون در هوش مصنوعی در ۲۰۲۶؛ از تحلیل داده تا ساخت مدلهای AI
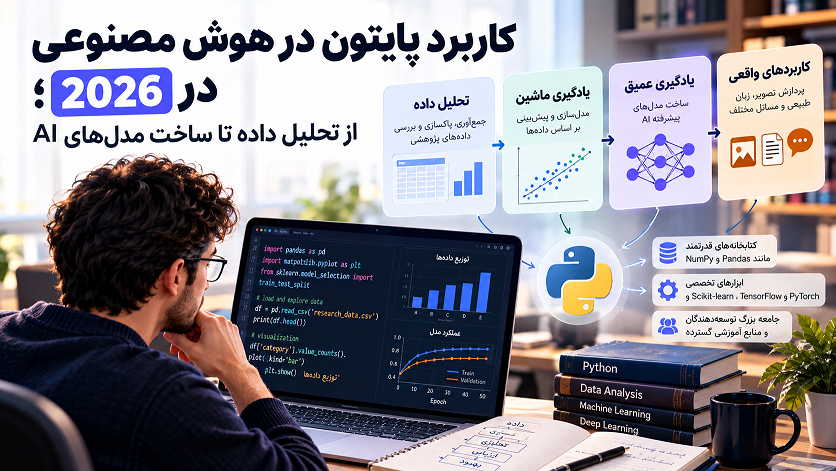
فرض کنید یک دانشجوی مهندسی برای پایاننامه خود چند هزار ردیف داده از حسگرهای آزمایشگاهی جمعآوری کرده است. بخشی از دادهها ناقصاند، تعدادی رکورد تکراری وجود دارد و هنوز مشخص نیست کدام متغیرها واقعاً با نتیجه آزمایش ارتباط دارند. در چنین پروژهای، اولین قدم ساخت مدل هوش مصنوعی نیست؛ ابتدا باید داده خوانده، پاکسازی، تحلیل و آماده شود.
اینجاست که پایتون در هوش مصنوعی نقش واقعی خود را نشان میدهد. Python فقط برای نوشتن الگوریتمهای یادگیری ماشین استفاده نمیشود؛ در بسیاری از پروژهها، از مرحله دریافت داده تا تحلیل آماری، ساخت مدل، ارزیابی و اجرای مجدد آزمایشها در همان اکوسیستم انجام میشود.
عبارت هوش مصنوعی پایتون نیز معمولاً با همین سؤال جستوجو میشود: Python دقیقاً در کدام بخش از ساخت یک سیستم هوشمند کاربرد دارد؟ پاسخ کوتاه این است که تقریباً تمام مراحل بین «داده خام» و «مدل قابل استفاده» میتوانند با ابزارهای Python مدیریت شوند.
طبق مستندات رسمی Python، این زبان ساختارهای داده سطح بالا، نحو نسبتاً ساده و امکانات مناسبی برای توسعه سریع دارد. همین ویژگی، در کنار کتابخانههایی مانند NumPy، pandas، scikit-learn، TensorFlow و PyTorch، باعث شده Python به یکی از زبانهای مهم در Data Science و Machine Learning تبدیل شود.
| موضوع | نقش Python |
|---|---|
| تحلیل داده | پاکسازی، تبدیل، بررسی و مصورسازی دادهها |
| پژوهش دانشگاهی | تحلیل Dataset، نتایج آزمایش و خودکارسازی |
| Machine Learning | آمادهسازی داده، آموزش و ارزیابی مدل |
| Deep Learning | ساخت و آموزش شبکههای عصبی |
| NLP | پردازش و تحلیل متن |
| Computer Vision | پردازش تصویر و مدلهای بینایی |
| مسیر یادگیری | Python، داده، آمار، ML و پروژه عملی |
چرا Python در هوش مصنوعی زبان مهمی است؟
یکی از دلایل اصلی استفاده گسترده از Python در پروژههای AI، فاصله کم میان ایده و پیادهسازی است. پژوهشگر میتواند داده را بخواند، روی آن تغییر ایجاد کند، نمودار بسازد و یک مدل اولیه را بدون جابهجایی بین چند محیط کاملاً متفاوت آزمایش کند.
مستندات رسمی Python این زبان را چنین توصیف میکند: “Python is an easy to learn, powerful programming language.” خوانایی کد در پروژههای علمی اهمیت زیادی دارد؛ چون کدی که امروز نوشته میشود ممکن است چند ماه بعد توسط همان پژوهشگر یا فرد دیگری بررسی و دوباره اجرا شود.
دلیل مهم دیگر، اکوسیستم گسترده Python است. NumPy محاسبات عددی را پوشش میدهد، pandas برای دادههای جدولی مناسب است، Matplotlib و Seaborn برای مصورسازی استفاده میشوند، scikit-learn ابزارهای Machine Learning را ارائه میکند و TensorFlow و PyTorch برای Deep Learning به کار میروند.
برای کسی که میخواهد این مسیر را از مبانی کدنویسی تا مدلسازی دنبال کند، منابع ساختاریافته در حوزه آموزش برنامه نویسی هوش مصنوعی میتوانند در کنار مستندات رسمی و تمرین پروژهمحور، ارتباط میان برنامهنویسی، داده و مدلسازی را روشنتر کنند.
یکی از مهمترین مزیتهای Python همین پیوستگی ابزارهاست. پژوهشگر مجبور نیست داده را در یک نرمافزار پاکسازی کند، در ابزار دیگری نمودار بسازد و در محیط سوم مدل آموزش دهد.
این موضوع باعث شده کاربرد پایتون در هوش مصنوعی محدود به یک حوزه نباشد. Python در Data Science، Machine Learning، Deep Learning، پردازش زبان طبیعی و Computer Vision کاربرد دارد. البته این موضوع به معنای برتری مطلق Python بر همه زبانها نیست. در بعضی سامانههای صنعتی، بخشهای حساس به Performance ممکن است با زبانهایی مانند C++ یا Rust پیادهسازی شوند.
پایتون در تحلیل داده چه کاربردی دارد؟
بخش بزرگی از یک پروژه هوش مصنوعی قبل از آموزش مدل اتفاق میافتد. داده خام معمولاً دقیقاً در همان قالبی وارد پروژه نمیشود که الگوریتم انتظار دارد.
در تحلیل داده با پایتون معمولاً این مراحل انجام میشوند:
- دریافت داده
- بررسی ساختار Dataset
- شناسایی مقادیر گمشده
- حذف دادههای تکراری
- تحلیل اکتشافی
- مصورسازی
- آمادهسازی برای مدل
pandas یکی از ابزارهای اصلی این مرحله است. ساختار DataFrame در این کتابخانه برای دادههای جدولی مناسب است و امکان فیلتر، گروهبندی، ترکیب و مدیریت دادههای ناقص را فراهم میکند.
مثال پژوهشی ساده
فرض کنید در یک پروژه دانشگاهی، دادههای دما، رطوبت و مصرف انرژی یک ساختمان طی چند ماه ثبت شدهاند و هدف، پیشبینی مصرف انرژی است. پیش از انتخاب الگوریتم باید بررسی شود آیا همه حسگرها داده ثبت کردهاند، واحدها یکسان هستند و مقادیر غیرعادی ناشی از وضعیت واقعیاند یا خطای اندازهگیری.
بعد از پاکسازی، تحلیل اکتشافی آغاز میشود. آیا مصرف انرژی با افزایش دما تغییر میکند؟ آیا آخر هفته الگوی متفاوتی دارد؟ آیا بعضی حسگرها خروجی غیرعادی ثبت کردهاند؟
در چنین پروژهای pandas برای مدیریت داده و Matplotlib یا Seaborn برای مشاهده الگوها به کار میروند.
طبق مستندات Matplotlib، این کتابخانه برای ساخت مصورسازیهای ایستا، متحرک و تعاملی طراحی شده است. در پژوهش، نمودار فقط برای زیبایی نیست؛ گاهی یک Scatter Plot ساده مسئلهای را نشان میدهد که در هزاران ردیف داده بهراحتی قابل مشاهده نیست.
کتابخانههای Python برای هوش مصنوعی و علم داده

وجود کتابخانههای تخصصی یکی از دلایل مهم گسترش پایتون برای هوش مصنوعی است.
| کتابخانه | کاربرد |
|---|---|
| NumPy | محاسبات عددی و آرایهها |
| Pandas | تحلیل و پاکسازی داده |
| Matplotlib | مصورسازی |
| Seaborn | نمودارهای آماری |
| Scikit-learn | یادگیری ماشین |
| TensorFlow / PyTorch | یادگیری عمیق |
NumPy
NumPy در مستندات رسمی بهعنوان یکی از بستههای بنیادی محاسبات علمی Python معرفی میشود. این کتابخانه برای کار با آرایهها، ماتریسها، جبر خطی و عملیات عددی مناسب است.
pandas
pandas بیشتر در کار با دادههای جدولی استفاده میشود. برای مثال میتوان ستونها را فیلتر کرد، دادههای ناقص را شناسایی کرد یا چند Dataset را با هم ترکیب کرد. برای شروع Python در Data Science، تسلط روی pandas معمولاً از رفتن مستقیم سراغ مدلهای پیچیده مفیدتر است.
Matplotlib و Seaborn
مصورسازی بخشی از تحلیل است. Histogram برای بررسی توزیع، Scatter Plot برای مشاهده رابطه میان متغیرها و Box Plot برای بررسی دادههای پرت کاربرد دارند.
scikit-learn
scikit-learn مجموعهای از ابزارهای Machine Learning را ارائه میکند و بخشهایی برای Classification، Regression، Clustering، Preprocessing و Model Selection دارد. برای کسی که میخواهد یادگیری ماشین با پایتون را شروع کند، این کتابخانه نقطه ورود مناسبی است.
TensorFlow و PyTorch
TensorFlow و PyTorch هر دو برای ساخت و آموزش مدلهای یادگیری عمیق استفاده میشوند. انتخاب بین آنها به پروژه، تجربه تیم و نوع زیرساخت بستگی دارد.
پایتون در Machine Learning چه نقشی دارد؟
Python در Machine Learning فقط در لحظه ساخت مدل استفاده نمیشود. تقریباً تمام Pipeline میتواند با Python مدیریت شود. ابتدا داده آماده میشود. مقادیر ناقص اصلاح میشوند، ستونهای غیرضروری کنار گذاشته میشوند و در صورت نیاز دادهها تبدیل یا مقیاسبندی میشوند.
سپس ویژگیهای مناسب مشخص میشوند و داده به بخشهای آموزش و ارزیابی تقسیم میشود. مدل روی داده آموزشی الگو پیدا میکند و بعد روی دادهای که قبلاً ندیده است بررسی میشود. عملکرد خوب روی داده آموزش بهتنهایی کافی نیست؛ مدل باید روی داده جدید نیز رفتار مناسبی داشته باشد.
scikit-learn ابزارهایی برای Preprocessing، Model Selection و Metrics دارد و بخش زیادی از این مراحل را پوشش میدهد.
Classification و Regression چه تفاوتی دارند؟
در Classification خروجی یک دسته است. برای مثال، تشخیص «اسپم» یا «غیراسپم» یک مسئله Classification است. در Regression خروجی معمولاً یک مقدار عددی پیوسته است؛ مثل پیشبینی مصرف انرژی یا قیمت یک خانه.
نکته مهم این است که دانستن دستورهای fit() و predict() به معنای درک Machine Learning نیست. کاربر باید بداند چرا داده آموزش و آزمون جدا میشوند، Overfitting چیست و هر معیار ارزیابی چه معنایی دارد.
پایتون در پژوهشهای دانشگاهی چه کاربردی دارد؟
برای دانشجو و پژوهشگر، Python الزاماً از ساخت مدل پیچیده شروع نمیشود. گاهی یک اسکریپت کوچک که یک کار تکراری را خودکار میکند، ارزش بیشتری دارد. یکی از کاربردهای رایج، تحلیل Datasetهای پژوهشی است. داده ممکن است از پرسشنامه، حسگر، تجهیزات آزمایشگاهی یا پایگاههای عمومی جمعآوری شده باشد.
Python میتواند این دادهها را بخواند، فرمتها را یکسان کند، رکوردهای نامعتبر را جدا کند و مراحل تحلیل را بهصورت قابل تکرار اجرا کند. در پژوهشهای آزمایشگاهی نیز میتوان خروجی چندین آزمایش را بهطور خودکار پردازش کرد. بهجای باز کردن فایلها یکییکی، یک اسکریپت میتواند ستونهای مشخص را استخراج و در یک DataFrame واحد ترکیب کند.
در تجربه عملی، این قابلیت اهمیت زیادی دارد؛ چون تکرار دستی یک تحلیل احتمال خطا و ناهماهنگی را افزایش میدهد. پردازش متن نیز کاربرد دیگری است. پژوهشگری که صدها پاسخ متنی، چکیده مقاله یا سند دارد میتواند از Python برای پاکسازی متن، شمارش واژهها، استخراج ویژگی و آمادهسازی داده برای NLP استفاده کند.
مصورسازی نیز بخشی از همین فرایند است. نمودارها میتوانند روند، تفاوت گروهها یا وجود دادههای پرت را روشن کنند.
ساخت هوش مصنوعی با Python چگونه انجام میشود؟
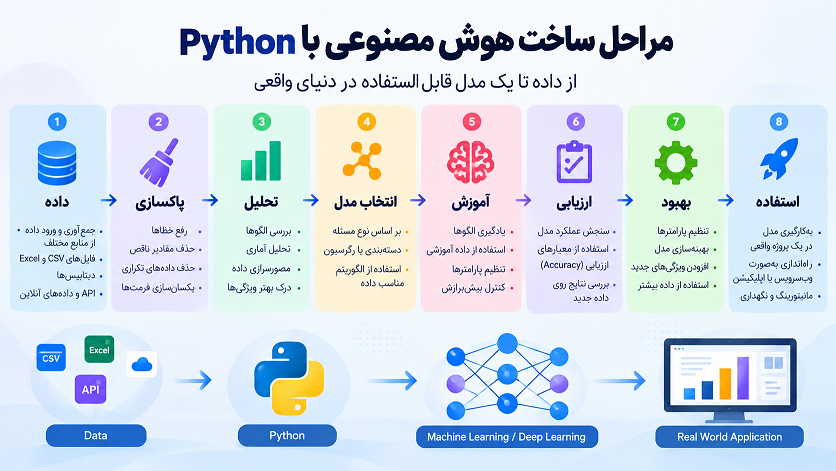
عبارت ساخت هوش مصنوعی با پایتون گاهی این تصور را ایجاد میکند که چند خط کد برای ساخت یک سیستم کامل کافی است. در عمل، پروژه AI از چند مرحله تشکیل میشود:
داده
↓
پاکسازی
↓
تحلیل
↓
انتخاب مدل
↓
آموزش
↓
ارزیابی
↓
بهبود
↓
استفاده در پروژه واقعی
فرض کنید هدف تشخیص نوع یک تصویر است. ابتدا باید مجموعهای از تصاویر مناسب وجود داشته باشد. تصاویر باید در قالب مشخص آماده شوند و معمولاً به برچسب نیاز دارند. سپس داده به بخشهای آموزش و ارزیابی تقسیم میشود. مدل روی داده آموزشی یاد میگیرد و روی دادهای که قبلاً ندیده است ارزیابی میشود.
اگر نتیجه ضعیف باشد، بزرگتر کردن مدل لزوماً راهحل نیست. ممکن است مشکل از Dataset، برچسبها یا روش ارزیابی باشد. طبق آموزش رسمی PyTorch، ساخت مدل شامل مراحلی مانند آمادهسازی Dataset، تعریف مدل، Optimization و ذخیره یا استفاده از مدل است.
بنابراین هوش مصنوعی با پایتون بیش از آنکه به حفظ کردن دستورهای یک کتابخانه وابسته باشد، به درک کل Workflow وابسته است.
آیا برای یادگیری هوش مصنوعی باید ابتدا Python یاد گرفت؟
برای مسیرهای تخصصی AI، Data Science و Machine Learning، آشنایی با Python اهمیت زیادی دارد؛ اما لازم نیست فرد قبل از شروع AI به تمام جزئیات Python مسلط باشد. مهمترین مباحث اولیه شامل متغیرها، شرطها، حلقهها، توابع، List، Dictionary، کار با فایلها و حل مسئله هستند.
از نظر من، توانایی خواندن و فهم کد حتی از حفظ کردن Syntax مهمتر است. فرد باید بتواند بفهمد یک تابع چه ورودیای دریافت میکند، روی داده چه تغییری انجام میدهد و چه خروجیای تولید میکند. در آموزش پایتون برای هوش مصنوعی بهتر است مفاهیم زبان در کنار مسائل واقعی تمرین شوند. مثلاً حلقه را با پردازش چند فایل و تابع را با ساخت یک مرحله قابل استفاده مجدد در تحلیل داده تمرین کرد.
پایتون برای هوش مصنوعی از کجا شروع کنیم؟
یکی از سؤالهای رایج در جستوجوهای مرتبط با هوش مصنوعی پایتون این است که نقطه شروع کجاست.
مسیر منطقی معمولاً اینطور است:
Python → Data Analysis → NumPy / Pandas → Statistics → Machine Learning → Deep Learning → Project
ابتدا باید بتوان با Python برنامههای ساده نوشت. بعد نوبت کار با داده است.
در مرحله بعد، NumPy و pandas وارد مسیر میشوند. سپس آمار پایه مانند میانگین، واریانس، توزیع و همبستگی اهمیت پیدا میکند. بعد از آن میتوان سراغ الگوریتمهای ساده Machine Learning رفت. بهتر است Deep Learning زمانی شروع شود که مفاهیمی مثل Train/Test Split، Overfitting، Feature و Metric دیگر کاملاً ناآشنا نباشند.
برای ورود به حوزه AI با Python چه مهارتهایی لازم است؟
در کنار Python، چند مهارت دیگر اهمیت زیادی دارند. فرد باید بتواند داده را بخواند و مشکلات آن را شناسایی کند. دانش پایه آمار برای تفسیر صحیح نتایج ضروری است و Machine Learning نیز فقط با شناخت الگوریتم کامل نمیشود.
scikit-learn در این مرحله ابزارهای Preprocessing، Validation و Model Evaluation را فراهم میکند. پس از آن میتوان وارد Deep Learning و ابزارهایی مانند TensorFlow و PyTorch شد. اما مهمترین مهارت، حل مسئله است. در پروژه واقعی، سؤال اصلی این نیست که چند کتابخانه میشناسید؛ مهم این است که آیا میتوانید یک مسئله مبهم را به داده، فرضیه، آزمایش و نتیجه قابل دفاع تبدیل کنید.
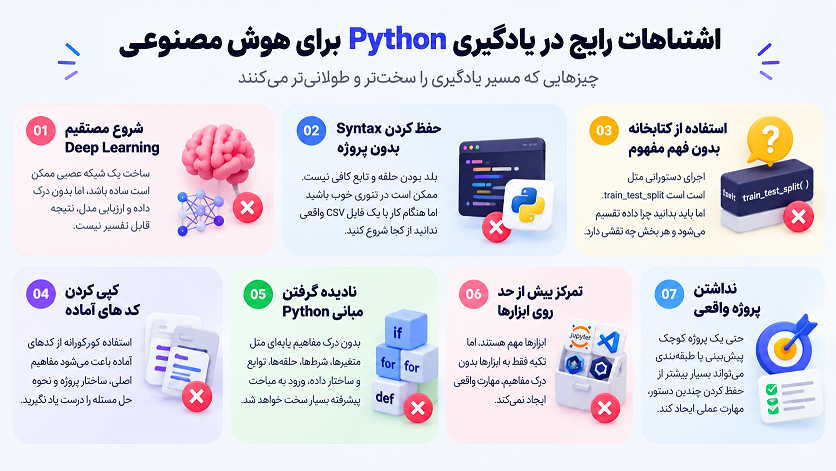
شروع مستقیم با Deep Learning یکی از رایجترین اشتباههاست. ساخت یک شبکه عصبی ممکن است از نظر کدنویسی ساده باشد، اما بدون درک داده و ارزیابی مدل، نتیجه قابل تفسیر نیست. حفظ کردن Syntax بدون پروژه نیز مشکل دیگری است. کسی ممکن است حلقه و تابع را بلد باشد، اما هنگام روبهرو شدن با یک CSV واقعی نداند از کجا شروع کند.
استفاده از کتابخانه بدون فهم مفهوم هم خطرناک است. اجرای train_test_split ساده است، اما فرد باید بداند چرا داده تقسیم میشود. کپی کردن کد آماده، نادیده گرفتن مبانی Python، تمرکز بیش از حد روی ابزارها و نداشتن پروژه واقعی نیز از اشتباهات رایج هستند. حتی یک پروژه کوچک پیشبینی یا طبقهبندی میتواند بسیار بیشتر از حفظ کردن چندین دستور، مهارت عملی ایجاد کند.
آینده Python در هوش مصنوعی چگونه خواهد بود؟
پیشبینی قطعی درباره آینده زبانهای برنامهنویسی منطقی نیست، اما اکوسیستم فعلی نشان میدهد Python همچنان نقش مهمی در Data Science و توسعه مدلهای AI دارد. NumPy، pandas، scikit-learn، TensorFlow و PyTorch هرکدام بخش مهمی از چرخه داده و مدل را پوشش میدهند. با این حال، صرف دانستن Python برای بازار کار کافی نیست. ارزش واقعی زمانی شکل میگیرد که Python با دانش داده، آمار، Machine Learning و توانایی حل مسئله ترکیب شود.
جمعبندی سریع مسیر و کاربردها
| هدف | ابزار یا مهارت |
|---|---|
| دادههای عددی | NumPy |
| پاکسازی Dataset | pandas |
| مصورسازی | Matplotlib / Seaborn |
| مدلهای کلاسیک ML | scikit-learn |
| شبکههای عصبی | TensorFlow / PyTorch |
| پژوهش دانشگاهی | Python + داده + آمار |
| ورود به AI | Python + ML + پروژه واقعی |
سوالات متداول
آیا Python برای هوش مصنوعی مناسب است؟
بله. اکوسیستم گسترده کتابخانههای تحلیل داده، Machine Learning و Deep Learning باعث شده Python برای بسیاری از پروژههای AI مناسب باشد.
آیا برای یادگیری AI باید Python بلد باشیم؟
برای مسیرهای عملی، بهتر است مبانی Python را بدانید؛ اما لازم نیست از ابتدا به تمام جزئیات زبان مسلط باشید.
بهترین کتابخانه Python برای AI چیست؟
یک پاسخ واحد وجود ندارد. scikit-learn برای Machine Learning کلاسیک و TensorFlow و PyTorch برای Deep Learning کاربرد دارند.
آیا با Python میتوان مدل هوش مصنوعی ساخت؟
بله. با ابزارهایی مانند scikit-learn، TensorFlow و PyTorch میتوان مدل را تعریف، آموزش و ارزیابی کرد.
یادگیری Python برای ورود به Machine Learning از کجا شروع میشود؟
از مبانی زبان، کار با داده، NumPy، pandas و آمار پایه شروع کنید و سپس وارد مدلهای ساده Machine Learning شوید.
جمعبندی
پایتون در هوش مصنوعی یک ابزار مهم برای مدیریت مسیر داده تا مدل است. با Python میتوان داده پژوهشی را پاکسازی کرد، نمودار ساخت، مدل Machine Learning آموزش داد و وارد پروژههای Deep Learning شد. در عین حال، هوش مصنوعی پایتون یا برنامهنویسی AI را نباید به یادگیری چند کتابخانه محدود کرد. اجرای چند تابع بدون درک داده، آمار و منطق الگوریتم به دانش واقعی Machine Learning منجر نمیشود.
برای دانشجو و پژوهشگر، مزیت اصلی Python این است که تحلیل علمی و برنامهنویسی را در یک محیط نزدیک به هم قرار میدهد. همان کدی که داده را پاکسازی میکند، میتواند برای مصورسازی، مدلسازی و تکرار آزمایش نیز استفاده شود. بهترین مسیر یادگیری، ترکیب مبانی Python با داده واقعی، تحلیل، آمار و پروژه عملی است. Python ابزار را فراهم میکند؛ کیفیت نتیجه را درک مسئله، توانایی تحلیل و تجربه اجرای پروژه تعیین میکند.